李宁商城检索返回数据会混合常规商品、推广展位、套装组合款,很多常规写法只做基础请求,缺少 SPU 与 SKU 的分层剥离。本文从商品入库的业务视角封装检索逻辑,把同 SPU 的多规格信息收拢,过滤营销推广条目,统一输出稳定字段,方便后续联动详情拉取、批量快照同步。核心难点在于请求指纹校验、嵌套规格解析、分页边界判断。 这套方案和通用教程的区别,是优先以 SPU 作为主键做数据收拢,避免同一个商品的多个 SKU 重复入库。会话复用头部信息,维持指纹一致性,减少频繁请求触发的校验拦截。代码只保留业务需要的核心字段,剔除冗余的前端渲染字段,降低存储压力。 落地时有几个高频卡点。第一,请求头不能随意删减,缺少 Referer 和 UA 很容易返回空数据;第二,平台有访问频次管控,连续翻页建议增加 0.5s 以上间隔,高频访问容易触发人机校验;第三,新品标识、库存状态为动态快照,仅适合定时采集,不可直接作为实时下单判断依据;第四,分页不要写死循环次数,根据 total 数值动态终止,减少无效请求。 检索拿到 spu_id 之后,可以直接传入商品详情拉取逻辑,形成完整的数据链路。长期定时同步场景,建议以 spu_id 作为唯一标识做去重,避免重复存储。该封装轻量化,适合中小规模商品快照采集,兼顾返回稳定性和数据纯净度。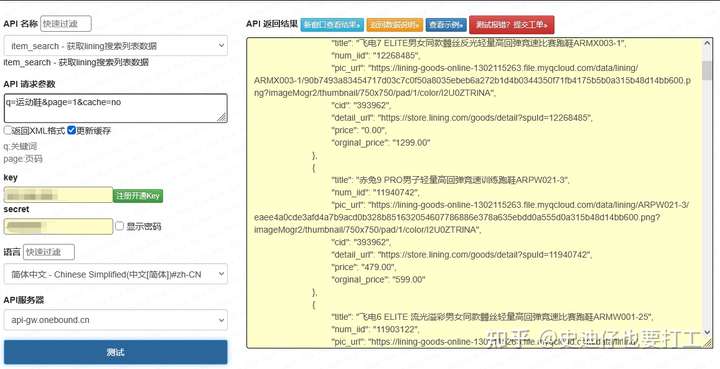
import requests
import time

class LiningSearchFetch:
    def __init__(self):
        self.session = requests.Session()
        self.base_url = "https://store.lining.com/api/search/goods"
        self.headers = {
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
            "Referer": "https://store.lining.com/",
            "Accept": "application/json",
            "sec-fetch-dest": "empty"
        }

    def fetch_goods_list(self, keyword, page=1, size=24):
        params = {
            "keyword": keyword,
            "pageNum": page,
            "pageSize": size
        }
        try:
            resp = self.session.get(self.base_url, params=params, headers=self.headers, timeout=10)
            resp.raise_for_status()
            res_json = resp.json()
            result_list = []
            goods_items = res_json.get("data", {}).get("records", [])
            for item in goods_items:
                # 过滤推广广告商品
                if item.get("isPromotion") == 1:
                    continue
                row = {
                    "spu_id": item.get("spuId"),
                    "goods_title": item.get("goodsName"),
                    "cover_img": item.get("mainPic"),
                    "sale_price": item.get("salePrice"),
                    "market_price": item.get("originalPrice"),
                    "category_name": item.get("categoryName"),
                    "is_new": item.get("isNewGoods"),
                    "stock_flag": item.get("hasStock")
                }
                result_list.append(row)
            return {
                "total": res_json.get("data", {}).get("total"),
                "list": result_list
            }
        except Exception as err:
            print(f"检索异常:{err}")
            return None

if __name__ == "__main__":
    searcher = LiningSearchFetch()
    ret = searcher.fetch_goods_list(keyword="跑鞋", page=1, size=24)
    if ret:
        for goods in ret["list"]:
            print(goods)