前言 17 货源(一起做网店)是广州沙河、十三行等服装批发市场线上 B2B 货源平台,关键词商品列表接口常用于服装选品、档口货源监控、款号比价业务。网上多数示例只做简单请求演示,忽略该平台业务特征:返回数据包含档口市场摊位信息、起批门槛、多档口同款重复铺货、高页码分页漂移、部分字段动态缺失。本文跳出基础调用 Demo,聚焦货源业务字段提取、同款商品去重、分页边界校验、异常数据过滤,提供面向生产同步的封装方案。 对接前需要在平台开发者后台申请 完整代码示例 核心差异化设计思路 B2B 货源定向解析:专门提取批发价、起批量、批发市场、档口摊位,这些是服装货源业务核心字段,区别普通电商只取标题价格。 同款货源内存去重:平台不同档口会铺货同款,利用 分页参数强校验:拦截非法页码、超最大单页条数,规避深度分页返回漂移错乱数据。 脏货源过滤:自动剔除批发价为空、无效占位商品,减少后续人工筛选成本。 线上对接避坑要点 站点参数 深度分页问题:高页码会出现商品重复、顺序错乱,业务不要无脑循环拉取全部 total,建议限定前 20 页。 调用频率:接口 QPS 不宜过高,批量采集每页必须增加延时,高频请求会临时封禁密钥权限。 签名注意:所有非空公共参数都参与签名,时间戳为秒级时间戳,时间偏差过大会鉴权失败。app_key与app_secret接口凭证,接口返回包含商品货号、批发价、起批量、所属批发市场、档口摊位等服装 B2B 特有的字段一起做网店。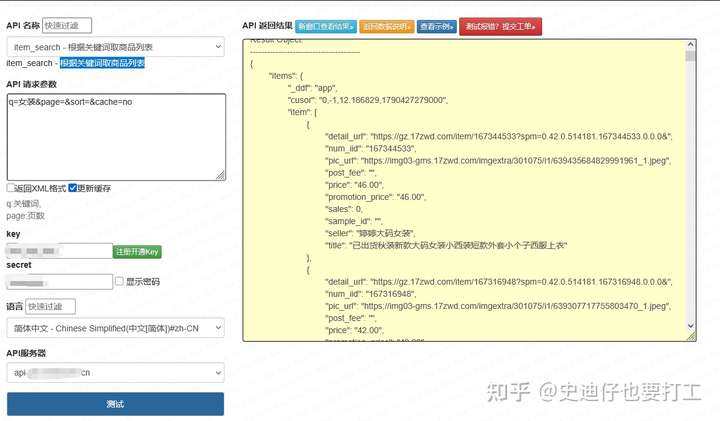
import requests
import time
import hashlib

class SeventeenZwdSearch:
    def __init__(self, app_key, app_secret):
        self.app_key = app_key
        self.app_secret = app_secret
        self.api_url = "https://open.17zwd.com/api/goods/search"
        self.session = requests.Session()
        self.seen_goods = set() # 全局去重,过滤多档口同款
        self.page_sleep = 0.6

    def build_sign(self, params):
        """按照平台规则生成md5签名"""
        sorted_items = sorted(params.items())
        raw_str = "".join([f"{k}{v}" for k, v in sorted_items]) + self.app_secret
        return hashlib.md5(raw_str.encode("utf‑8")).hexdigest().upper()

    def keyword_search(self, keyword, site="gz", page=1, page_size=20):
        # 前置参数拦截,平台限制单页最大50条
        if page < 1 or page_size > 50:
            return {"ok":False, "msg":"分页参数非法", "data":[]}
        params = {
            "app_key": self.app_key,
            "site": site,
            "keyword": keyword,
            "page": page,
            "page_size": page_size,
            "timestamp": str(int(time.time()))
        }
        params["sign"] = self.build_sign(params)
        try:
            resp = self.session.get(self.api_url, params=params, timeout=16)
            resp.raise_for_status()
            resp_json = resp.json()
        except Exception as e:
            return {"ok":False, "msg":f"网络异常:{str(e)}", "data":[]}

        if resp_json.get("code") != 200:
            return {"ok":False, "msg":resp_json.get("msg","接口业务异常"), "data":[]}

        raw_list = resp_json.get("data",{}).get("list",[])
        clean_result = []
        for item in raw_list:
            goods_id = item.get("goods_id")
            # 去重 + 过滤无效无批发价商品
            if not goods_id or goods_id in self.seen_goods or float(item.get("wholesale_price",0)) <= 0:
                continue
            self.seen_goods.add(goods_id)
            clean_result.append({
                "goods_id": goods_id,
                "title": item.get("title","").strip(),
                "goods_sn": item.get("goods_sn",""),
                "wholesale_price": float(item.get("wholesale_price",0)),
                "min_batch": item.get("min_batch",1),
                "shop_name": item.get("shop_name",""),
                "market_name": item.get("market_name",""),
                "stall_no": item.get("stall_no","")
            })
        time.sleep(self.page_sleep)
        return {
            "ok": True,
            "total": resp_json.get("data",{}).get("total",0),
            "data": clean_result
        }

if __name__ == "__main__":
    client = SeventeenZwdSearch("your_app_key","your_app_secret")
    ret = client.keyword_search(keyword="牛仔阔腿裤", site="gz", page=1)
print("清洗后货源列表:", ret["data"])goods_id集合做全局去重,避免统计重复款式。site:gz代表广州站,支持杭州、普宁等多个站点切换,检索广州货源必须传入 gz 参数一起做网店。