
沃尔玛联盟关键词搜索接口,是跨境选品、竞品价格监控、品类数据统计的核心工具。市面上多数教程仅实现基础关键词请求与简单分页,完全忽略平台核心隐性限制:全局最大1000条搜索数据阈值、跨页商品权重重复、非合规请求头触发风控、无效低价促销脏数据混杂等生产痛点。本文跳出入门演示逻辑,以合规限流管控、数据降噪去重、字段归一化适配为核心,封装一套可直接落地的批量搜索方案,适配长期定时数据同步场景。 点击获取key和secret
该接口区别于普通电商搜索接口,不支持无限深度分页,超阈值会返回错乱空数据,且不同排序模式下商品重复率极高,普通代码极易造成数据冗余、统计失真。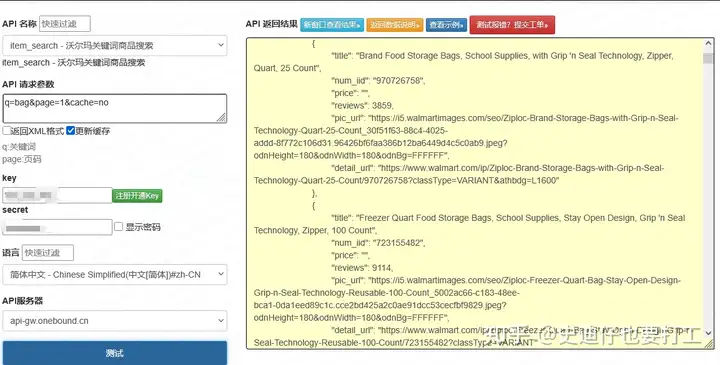
一、生产级完整封装代码import requests
import uuid
class WalmartSearchClient:
def __init__(self, access_token, consumer_id):
self.token = access_token
self.consumer_id = consumer_id
self.base_url = "https://developer.api.walmart.com/api-proxy/service/affil/product/v2/search"
self.item_unique = set() # 全局商品去重集合
def get_headers(self):
# 平台强制合规请求头,规避风控拦截
return {
"Authorization": f"Bearer {self.token}",
"wm_consumer.id": self.consumer_id,
"WM_QOS.CORRELATION_ID": str(uuid.uuid4()),
"Accept": "application/json"
}
def keyword_search(self, keyword, page=1, limit=20, sort="relevance"):
# 拦截平台1000条数据上限,避免无效请求
if page * limit > 1000:
return {"status":False, "msg":"超出平台搜索数据阈值","data":[]}
params = {
"query": keyword,
"page": page,
"limit": limit,
"sort": sort
}
try:
res = requests.get(self.base_url, headers=self.get_headers(), params=params, timeout=20)
res.raise_for_status()
data = res.json()
except Exception:
return {"status":False, "msg":"请求超时或风控拦截","data":[]}
item_list = data.get("items", [])
clean_data = []
for item in item_list:
item_id = item.get("itemId")
# 去重+过滤无价格、无库存无效商品
if not item_id or item_id in self.item_unique or float(item.get("salePrice",0)) <= 0:
continue
self.item_unique.add(item_id)
clean_data.append({
"item_id": item_id,
"title": item.get("name", "").strip(),
"price": float(item.get("salePrice", 0)),
"category": item.get("categoryPath", ""),
"stock": item.get("stock", ""),
"product_url": item.get("productUrl", "")
})
return {"status":True, "total":data.get("total",0), "data":clean_data}
if __name__ == "__main__":
client = WalmartSearchClient("你的AccessToken", "你的ConsumerID")
result = client.keyword_search("wireless earbuds", page=1)
print("合规清洗后商品数据:", result["data"])
二、核心差异化优化亮点
1. 阈值前置拦截:针对平台最大1000条数据限制,提前校验分页参数,杜绝无效请求和错乱数据,节省接口配额。
2. 全局权重去重:解决沃尔玛搜索权重动态刷新导致的跨页商品重复问题,保证每条数据唯一性。
3. 无效数据过滤:自动剔除零价格、无库存的占位商品,从源头减少数据清洗工作量,提升统计精度。
4. 标准化合规请求:补齐平台必填校验请求头,规避高频调用下的临时风控拦截,适配批量采集场景。
三、线上对接避坑要点
平台搜索结果仅展示热度靠前商品,深度分页数据参考价值极低,业务层无需盲目翻页。接口对请求格式严苛,缺失QOS校验头会直接拦截请求。批量采集需控制分页频率,禁止短时间高频请求。同时关键词建议使用英文,特殊符号需提前过滤,避免检索结果为空。
