很多方案只做简单请求取值,忽略李宁商城页面数据分片加载、规格和图文分开返回的特点。直接请求详情页拿到的往往是碎片化数据,规格参数、主图、详情图文不在同一组返回内容里。本文思路优先做数据分片合并,把分散的规格、价格、库存、图文统一组装成标准化结果,方便后续入库、同步商品数据,规避单请求拿不全信息的问题。 运行环境:Python3.8+,依赖 requests、json。 请求要点:需要携带合理的请求头模拟客户端访问,缺少 UA、来源标识会直接返回校验拦截;商品唯一标识为商品 spu 编码,从搜索结果中提取,作为入参。 封装会话对象复用连接,减少重复握手开销。采用三路分片请求,分别拉取商品基础信息、SKU 规格库存、详情图文参数,再合并成统一结构体。 SKU 部分保留尺码、颜色、售价、库存字段,适合批发和比价场景;图文单独拉取避免主接口返回内容过大超时。增加超时捕获,防止长时间阻塞。 编码校验:部分商品 SPU 编码带大小写,平台校验区分大小写,传入错误会返回空数据。 访问频次:短时间大量并发会触发风控,建议增加随机间隔,控制单 IP 访问速率。 图文清洗:返回的详情内容自带样式标签,入库前可根据业务需求过滤无用标签。 库存为动态值,仅做快照获取,不能作为实时下单依据。 这套方案区别于直接解析网页源码的思路,直接对接后端分片数据,解析成本更低、数据更稳定。组装后的标准化结构,可直接对接存储服务,适合批量商品同步场景。在实际业务中,可在此基础上增加代理池、结果字段过滤、数据落库逻辑。前言
前置准备
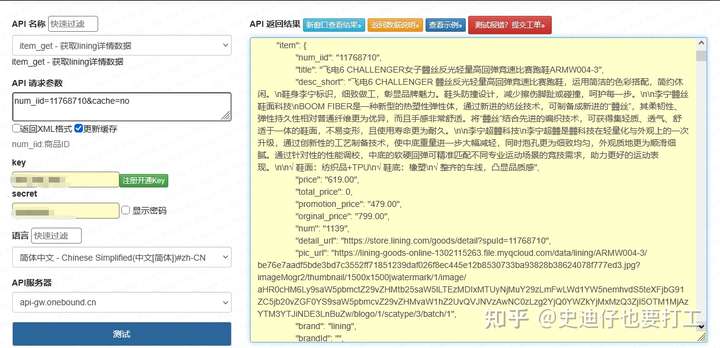
点击获取key和secret
完整示例代码
import requests
import json

class LiningDetailFetch:
    def __init__(self):
        self.session = requests.Session()
        self.headers = {
            "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
            "referer": "https://www.lining.com/",
            "accept": "application/json,text/plain,*/*"
        }
        self.session.headers.update(self.headers)

    def get_detail_info(self, spu_code):
        # 基础商品主体信息
        base_url = f"https://www.lining.com/api/goods/base?spuCode={spu_code}"
        # 规格sku、库存价格分片
        sku_url = f"https://www.lining.com/api/goods/skuList?spuCode={spu_code}"
        # 图文详情分片
        desc_url = f"https://www.lining.com/api/goods/desc?spuCode={spu_code}"

        try:
            resp_base = self.session.get(base_url, timeout=10)
            resp_sku = self.session.get(sku_url, timeout=10)
            resp_desc = self.session.get(desc_url, timeout=10)
            if resp_base.status_code != 200 or resp_sku.status_code !=200 or resp_desc.status_code !=200:
                return {"code":-1,"msg":"页面访问异常","data":None}

            base_data = resp_base.json().get("data",{})
            sku_list = resp_sku.json().get("data",[])
            desc_data = resp_desc.json().get("data",{})

            # 结构化组装
            result = {
                "spu": spu_code,
                "goods_name": base_data.get("goodsName",""),
                "brand": base_data.get("brandName",""),
                "category": base_data.get("categoryName",""),
                "main_images": base_data.get("mainPicList",[]),
                "sku_info": sku_list,
                "detail_html": desc_data.get("detailContent",""),
                "spec_params": desc_data.get("specList",[]),
                "sale_status": base_data.get("saleStatus",0)
            }
            return {"code":0,"msg":"success","data":result}
        except Exception as e:
            return {"code":-2,"msg":f"请求异常:{str(e)}","data":None}

if __name__ == "__main__":
    fetch = LiningDetailFetch()
    res = fetch.get_detail_info("L123456789")
    print(json.dumps(res,ensure_ascii=False,indent=2))
代码逻辑说明
落地避坑要点
总结