前言
京东工业面向企业采购场景,和普通零售站点检索逻辑差异很大,返回数据会包含含税价、MOQ 起订量、履约仓、企业专享价等 B 端独有字段,直接套用零售站检索方案很容易拿到无效数据。本文不做简单的请求封装,重点聚焦B 端业务字段归一化、广告商品过滤、分页终止判断三个业务痛点,提供可直接落地的调用示例,适配物资寻源、比价系统的开发需求。
前置准备
接入前需要在京东工业开放平台完成企业入驻,获取应用凭证与访问令牌;检索请求携带令牌,关键词需要做 url 编码,同时支持类目筛选、排序规则切换。B 端检索有严格的频次管控,必须内置退避重试,避免权限受限。
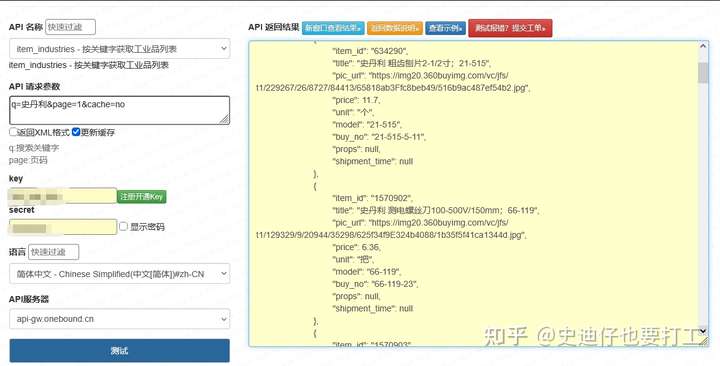
点击获取key和secret
代码实现
import requests
import time
import urllib.parse

class JdIndustrySearch:
    def __init__(self, token):
        self.token = token
        self.base_url = "https://iop.jd.com/industry/goods/search"
        self.session = requests.Session()
        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
        })

    def search_goods(self, keyword, page=1, page_size=20, cat_id=None):
        params = {
            "token": self.token,
            "keyword": urllib.parse.quote(keyword),
            "pageIndex": page,
            "pageSize": page_size
        }
        if cat_id:
            params["catId"] = cat_id
        try:
            resp = self.session.get(self.base_url, params=params, timeout=10)
            res_json = resp.json()
            if res_json.get("code") != 0:
                print(f"请求异常:{res_json.get('msg')}")
                return []
            raw_list = res_json.get("data", {}).get("goodsList", [])
            clean_list = []
            for item in raw_list:
                # 过滤广告推广商品
                if item.get("isAd") == 1:
                    continue
                clean_item = {
                    "skuId": item.get("skuId"),
                    "goodsName": item.get("goodsName"),
                    "taxPrice": item.get("taxPrice"),
                    "moq": item.get("moq"),
                    "stockNum": item.get("stockNum"),
                    "storeName": item.get("storeName")
                }
                clean_list.append(clean_item)
            return clean_list
        except Exception as e:
            print(f"网络异常:{str(e)}")
            return []

    def multi_page_search(self, keyword, max_page=3):
        all_data = []
        for p in range(1, max_page + 1):
            page_data = self.search_goods(keyword, page=p)
            if not page_data:
                break
            all_data.extend(page_data)
            time.sleep(0.8)
        return all_data

if __name__ == "__main__":
    searcher = JdIndustrySearch(token="你的access_token")
    result = searcher.multi_page_search("劳保手套", max_page=2)
    for row in result:
        print(row)
核心逻辑说明
广告过滤:B 端检索结果会混入推广商品,通过
isAd标记剔除,保证比价数据真实;字段裁剪:只保留采购业务核心字段,剔除冗余前端展示字段,减少存储压力;
分页终止:当单页返回空列表时自动停止,防止无限循环请求;
限流保护:每页请求增加休眠间隔,符合平台调用规范。
踩坑总结
第一,关键词编码不能省略,含特殊符号、中文的检索词不编码会返回空结果;第二,起订量 MOQ 是工业采购重点,部分商品 MOQ 大于 1,业务侧不能直接按单价计算成本;第三,令牌存在有效期,建议业务层做缓存并定时刷新;第四,类目筛选仅支持三级类目 ID,一级、二级类目传入会过滤失败。
总结
这套方案更贴合工业采购的业务场景,区别于普通零售检索脚本,重点解决 B 端数据降噪问题。可在此基础上扩展排序、类目筛选、批量入库等功能,用于企业物资比价、供应商寻源等业务系统。